
Stronniczość sztucznej inteligencji – czy możemy ufać decyzjom AI?
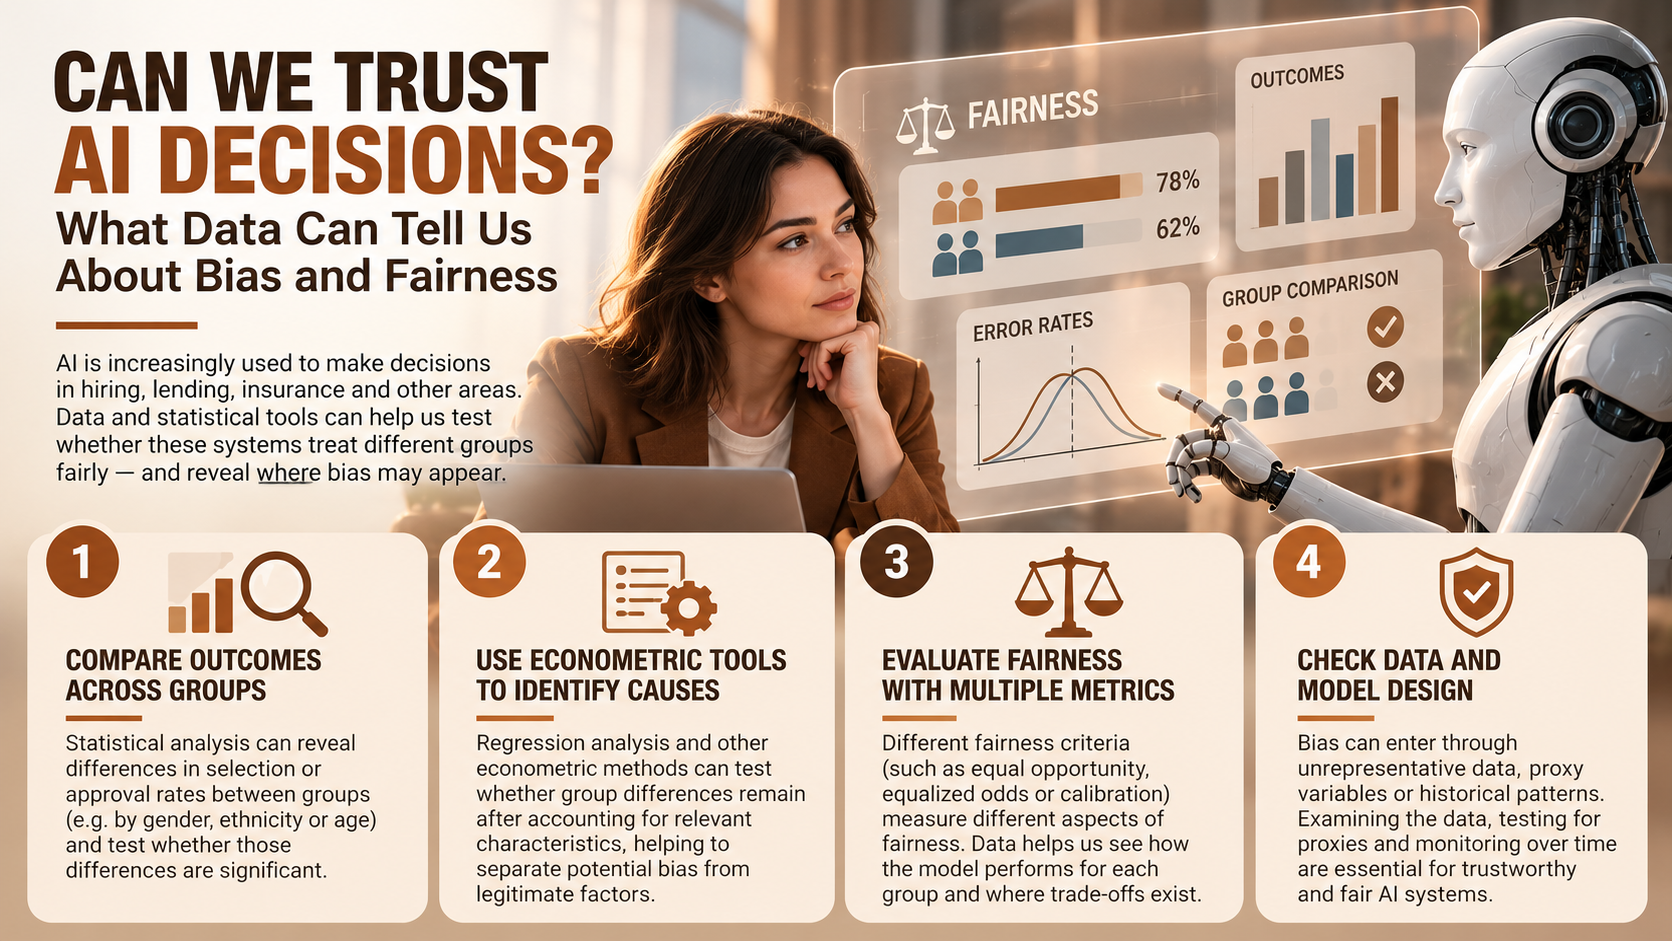
Stronniczość sztucznej inteligencji może prowadzić do nierównych decyzji dotyczących zatrudnienia, kredytów i dostępu do usług. Statystyka i ekonometria pozwalają porównywać wyniki różnych grup, analizować błędy modeli i identyfikować źródła nierówności. Dowiedz się, jak oceniać sprawiedliwość algorytmów i kiedy można zaufać decyzjom AI.
Sztuczna inteligencja pomaga organizacjom wybierać kandydatów do pracy, wykrywać podejrzane transakcje, rekomendować produkty i klasyfikować użytkowników. Ponieważ algorytmy wykorzystują reguły matematyczne, łatwo uznać ich decyzje za obiektywne. Modele uczą się jednak na danych pochodzących z rzeczywistych instytucji, rynków i ludzkich zachowań, które mogą zawierać historyczne nierówności. Zastąpienie człowieka algorytmem nie oznacza automatycznego wyeliminowania uprzedzeń.
Nie każda różnica w wynikach AI jest przejawem dyskryminacji. Grupy mogą różnić się obserwowalnymi cechami, jakością dostępnych danych lub skutecznością działania modelu. Nierówności mogą także wynikać ze struktury samego procesu decyzyjnego. Najważniejsze pytanie brzmi nie tylko, czy wyniki są różne, ale dlaczego pojawiają się te różnice.
Amerykański Narodowy Instytut Standaryzacji i Technologii (NIST) uznaje sprawiedliwość i ograniczanie szkodliwej stronniczości za elementy wiarygodnej AI. Jego podejście obejmuje również niezawodność, bezpieczeństwo, przejrzystość, odpowiedzialność, wyjaśnialność i prywatność. NIST wyróżnia stronniczość systemową, obliczeniową lub statystyczną oraz wynikającą z ludzkich procesów poznawczych. Pokazuje to, że problem nie sprowadza się do jednego błędu technicznego.
Statystyka i ekonometria umożliwiają bardziej szczegółową ocenę tych zagadnień. Badacze mogą porównywać wskaźniki wyboru, częstość błędów i skuteczność modeli między grupami oraz uwzględniać istotne cechy obserwowalne. Pozwala to sprawdzić, czy nierówności utrzymują się po uwzględnieniu alternatywnych wyjaśnień. Dane nie określają samodzielnie, co jest sprawiedliwe, ale pomagają ujawniać ukryte prawidłowości.
Stronniczość sztucznej inteligencji – testy statystyczne i różnice między grupami
Najprostsza analiza sprawiedliwości zaczyna się od porównania wyników. Załóżmy, że system rekrutacyjny AI ocenia 10 000 kandydatów i rekomenduje do rozmowy 60% osób z grupy A oraz 40% z grupy B. Różnica wynosząca 20 punktów procentowych jest wyraźna. Nie wyjaśnia jednak, dlaczego powstała.
Badacze mogą obliczać odsetki pozytywnych decyzji oraz porównywać różnice bezwzględne i względne. Takie analizy stosuje się również do przyznawania kredytów, decyzji ubezpieczeniowych, wykrywania oszustw czy rekrutacji na studia. Celem jest zastąpienie przypuszczeń mierzalnymi wynikami. Audyt algorytmu powinien rozpoczynać się od danych, a nie od założenia, że model jest neutralny.
Testy hipotez statystycznych pozwalają ocenić, czy obserwowane różnice mogą wynikać z losowej zmienności próby. Przedziały ufności pokazują niepewność oszacowań, a odpowiednio duże zbiory danych umożliwiają analizę podgrup. NIST w profilu generatywnej AI z 2024 roku zaleca stosowanie właściwych miar sprawiedliwości i testów statystycznych w procesach decyzyjnych. Pozwala to odróżniać przypadkowe wahania od bardziej trwałych wzorców.
Same odsetki pozytywnych decyzji nie opisują jednak całej sytuacji. Model może przyznawać podobną liczbę pozytywnych ocen dwóm grupom, ale znacznie częściej popełniać błędy wobec jednej z nich. Może również osiągać różne wskaźniki akceptacji przy porównywalnej trafności po uwzględnieniu odpowiednich cech. Równość wyników i równość skuteczności modelu to dwa różne kryteria statystyczne.
Dlatego analizuje się również błędy klasyfikacji. Wynik fałszywie dodatni występuje, gdy model błędnie przewiduje klasę pozytywną, a fałszywie ujemny, gdy niesłusznie odrzuca przypadek, który powinien zostać zakwalifikowany pozytywnie. Nierówny rozkład tych błędów między grupami może wskazywać na istotny problem. Ogólna trafność modelu może takie różnice ukrywać.
Wyobraźmy sobie system osiągający 90% trafności. Wynik wydaje się wysoki, ale jego ocena zmienia się, gdy trafność wynosi 95% w jednej grupie i tylko 70% w drugiej. Średnia nie pokazuje wtedy nierównej niezawodności modelu. Ocena AI wymaga analizowania skuteczności osobno dla odpowiednich populacji.
W zależności od zastosowania badacze mogą porównywać precyzję, czułość, wskaźniki wyników fałszywie dodatnich i fałszywie ujemnych oraz kalibrację. Wybór miary zależy od rodzaju decyzji i konsekwencji błędów. Inne kryteria będą istotne w rekrutacji, a inne w diagnostyce medycznej lub wykrywaniu oszustw. Nie istnieje jeden wskaźnik odpowiedni dla wszystkich systemów.
Stronniczość sztucznej inteligencji – jak ekonometria bada przyczyny nierówności
Proste porównania pozwalają wykrywać różnice, ale ekonometria umożliwia ich głębszą analizę. Załóżmy, że automatyczny system kredytowy rzadziej zatwierdza wnioski jednej grupy demograficznej. Sama różnica może wynikać z dochodów, zadłużenia, historii kredytowej, cech wniosku lub konstrukcji modelu. Analiza ekonometryczna pomaga sprawdzić, które czynniki mogą wyjaśniać obserwowane wyniki.
Regresja pozwala oszacować związek między przynależnością do grupy a decyzją po uwzględnieniu odpowiednich cech obserwowalnych. Badacze mogą porównywać osoby o podobnych dochodach, historii kredytowej, zadłużeniu i wnioskowanej kwocie. Jeśli po uwzględnieniu tych czynników utrzymuje się znaczna różnica, wymaga ona dalszego zbadania. Nie stanowi jednak automatycznie dowodu bezprawnej dyskryminacji.
Wyniki regresji zależą od doboru zmiennych, jakości pomiaru, postaci modelu i przyjętych założeń. Niektóre istotne cechy mogą pozostawać nieobserwowane lub być mierzone niedokładnie. Dodatkowo część zmiennych może być endogeniczna, co utrudnia interpretację zależności przyczynowych. Uwzględnienie wielu zmiennych nie zamienia automatycznie analizy obserwacyjnej w eksperyment.
Szczególnej ostrożności wymaga kontrolowanie cech, które same mogą być skutkiem historycznych nierówności. Zmienna może być statystycznie istotna, a jednocześnie przenosić wpływ mechanizmu, który badacz próbuje zidentyfikować. Jej uwzględnienie może prowadzić do niewłaściwej interpretacji. Nawet rozbudowany model może więc odpowiadać na źle sformułowane pytanie przyczynowe.
Inną metodą jest dopasowywanie obserwacji o podobnych cechach. Można porównywać osoby różniące się analizowaną cechą demograficzną, ale zbliżone pod względem innych obserwowalnych właściwości. Metoda ta również zależy od jakości i kompletności danych. Gdy jest to możliwe, eksperymenty i metody quasi-eksperymentalne mogą dostarczać silniejszych dowodów przyczynowych.
Przydatne są także testy kontrfaktyczne. Audytor może przygotować podobne zestawy danych wejściowych i zmienić jedną cechę lub jej przybliżony odpowiednik, aby sprawdzić reakcję modelu. NIST wymienia takie testy wśród metod oceny szkodliwej stronniczości generatywnej AI. Analiza kontrfaktyczna pozwala badać, jak zmiana określonej informacji wpływa na decyzję algorytmu.
Metody te przenoszą ocenę sprawiedliwości poza porównywanie średnich. Ekonometria wymaga określenia, które porównania są uzasadnione i jakie alternatywne wyjaśnienia należy uwzględnić. Nie dostarcza jednej uniwersalnej definicji sprawiedliwości. Umożliwia jednak bardziej uporządkowane badanie źródeł nierówności.
Stronniczość sztucznej inteligencji – dane treningowe i ukryte uprzedzenia
Jedną z częstych reakcji na ryzyko dyskryminacji jest usunięcie z modelu zmiennych takich jak płeć lub pochodzenie etniczne. W niektórych sytuacjach może to być pomocne, ale nie gwarantuje neutralności algorytmu. Inne cechy mogą być skorelowane z informacjami wrażliwymi i pośrednio odtwarzać podobne zależności. Model nie musi bezpośrednio wykorzystywać cechy chronionej, aby generować nierówne wyniki.
Przykładem jest kod pocztowy. Pozornie opisuje jedynie lokalizację, ale może być powiązany z dochodami, pochodzeniem mieszkańców, dostępem do usług i historycznymi warunkami mieszkaniowymi. Zaawansowany model może odtwarzać informacje demograficzne poprzez kombinacje takich zmiennych. Dlatego NIST zaleca sprawdzanie, czy cechy modelu nie pełnią funkcji pośrednich wskaźników przynależności do określonych grup.
Ważnym źródłem problemów są również historyczne etykiety wykorzystywane podczas treningu. Firma może stworzyć model rekrutacyjny przewidujący, którzy kandydaci przypominają pracowników uznawanych wcześniej za odnoszących sukcesy. Jeśli historyczne decyzje rekrutacyjne lub awanse faworyzowały określone środowiska, model może nauczyć się tych zależności. AI potrafi powielać wcześniejsze nierówności bez otrzymania bezpośredniej instrukcji dyskryminowania.
Automatyzacja może następnie zwiększać skalę takich problemów. System uczący się na historycznych decyzjach może stosować podobne wzorce do tysięcy lub milionów nowych przypadków. Nierówności nie muszą wynikać ze świadomych intencji programistów. Mogą być skutkiem zależności statystycznych obecnych w danych.
Stronniczość może również wynikać z brakujących informacji. Niektóre populacje są słabo reprezentowane w zbiorach treningowych, przez co model działa dobrze dla większości, ale nieprzewidywalnie dla mniejszych grup. Brookings opisuje podobny problem jako wykluczenie algorytmiczne, gdy niewystarczające dane uniemożliwiają uzyskanie wiarygodnych prognoz. Duży zbiór danych nie musi być reprezentatywny dla wszystkich użytkowników.
Jakość danych należy więc oceniać osobno dla poszczególnych populacji. Ważne są liczebność próby, brakujące obserwacje, dokładność pomiarów oraz zgodność populacji treningowej z rzeczywistymi użytkownikami systemu. Trzeba również analizować, czy mniejsze grupy zostały odpowiednio uwzględnione w testach. Rozmiar zbioru danych nie zastępuje jego reprezentatywności.
Jednorazowe sprawdzenie modelu przed wdrożeniem także nie wystarcza. Zachowania klientów, sytuacja na rynku pracy i warunki gospodarcze zmieniają się w czasie. Populacja korzystająca z systemu może stopniowo różnić się od tej, na której model był trenowany. Sprawiedliwość i skuteczność mogą więc pogarszać się nawet bez zmian w kodzie algorytmu.
Dlaczego nie istnieje jedna definicja sprawiedliwości algorytmów?
Jednym z najtrudniejszych zagadnień jest konflikt między różnymi definicjami sprawiedliwości. Organizacja może oczekiwać równych wskaźników akceptacji, podobnej częstości błędów lub jednakowej kalibracji prognoz. Każde z tych kryteriów opisuje inny aspekt działania modelu. Poprawa jednego wskaźnika nie musi oznaczać poprawy wszystkich pozostałych.
Demographic parity, czyli parytet demograficzny, sprawdza, czy grupy otrzymują pozytywne decyzje z podobną częstotliwością. W rekrutacji można porównywać odsetki kandydatów zapraszanych na rozmowę. Duże różnice mogą wskazywać na problem wymagający analizy. Sam wskaźnik nie określa jednak, czy kandydaci mają porównywalne cechy istotne dla decyzji.
Equal opportunity, czyli równość szans, koncentruje się na podobnym prawdopodobieństwie pozytywnej klasyfikacji wśród rzeczywiście kwalifikujących się osób. Equalized odds uwzględnia zarówno wskaźniki prawdziwie dodatnie, jak i fałszywie dodatnie. Kalibracja sprawdza natomiast, czy dana prognozowana wartość prawdopodobieństwa ma podobne znaczenie w różnych grupach. Kryteria te nie zawsze można spełnić jednocześnie.
NIST wymienia parytet demograficzny, equalized odds i equal opportunity wśród możliwych miar oceny procesów wykorzystujących AI. Zaleca jednocześnie dobieranie wskaźników do kontekstu we współpracy ze specjalistami i społecznościami, których dotyczą decyzje. Uniwersalna miara nie odpowiada wszystkim zastosowaniom. Wybór kryterium sprawiedliwości jest również decyzją społeczną i organizacyjną.
Znaczenie kontekstu widać szczególnie w sytuacjach, gdy błędy mają różne konsekwencje. W badaniach medycznych przeoczenie choroby może być znacznie poważniejsze niż błędne skierowanie zdrowej osoby na dodatkową diagnostykę. W wykrywaniu oszustw znaczenie mają zarówno fałszywe oskarżenia, jak i niewykryte nadużycia. W rekrutacji istotnym problemem może być niesłuszne odrzucenie wykwalifikowanego kandydata.
Ocena sprawiedliwości nie powinna więc należeć wyłącznie do analityków danych. Potrzebna może być współpraca prawników, ekonomistów, specjalistów branżowych, kierownictwa i grup objętych działaniem systemu. Różne zastosowania wymagają odmiennych standardów oraz oceny konsekwencji błędów. Statystyka potrafi mierzyć przyjęte kryterium, ale nie może samodzielnie zdecydować, które kryterium społeczeństwo powinno uznać za najważniejsze.
Pytanie o zaufanie do AI nie ma uniwersalnej odpowiedzi. Zależy ona od konkretnego systemu, rodzaju decyzji, jakości danych, konsekwencji błędów i stosowanych zabezpieczeń. Algorytm rekomendujący filmy generuje inne ryzyko niż model wpływający na zatrudnienie, kredyty czy decyzje medyczne. Wiarygodność AI należy oceniać w kontekście jej rzeczywistego zastosowania.
Dane mogą dostarczać dowodów potrzebnych do takiej oceny. Wskaźniki akceptacji pokazują nierówności wyników, analiza błędów ujawnia różnice w skuteczności, a ekonometria pozwala uwzględniać odpowiednie cechy obserwowalne. Testy kontrfaktyczne pomagają badać reakcje algorytmu na zmiany danych wejściowych. Dzięki temu ogólne obawy dotyczące uprzedzeń można przekształcić w konkretne pytania badawcze.
Sam pomiar nie jest jednak wystarczający. Audyt powinien obejmować sposób zbierania danych, brakujące obserwacje, skuteczność modelu w podgrupach i obecność zmiennych zastępczych. Należy również analizować, w jaki sposób organizacja wykorzystuje wyniki algorytmu. Badania Brookings dotyczące audytów algorytmów rekrutacyjnych podkreślają znaczenie tych elementów.
Monitorowanie musi być kontynuowane po wdrożeniu. NIST AI Risk Management Framework organizuje zarządzanie ryzykiem wokół czterech funkcji: Govern, Map, Measure i Manage. Podejście to zakłada ocenę ryzyka w całym cyklu życia systemu, a nie tylko podczas jednorazowego testu. NIST prowadzi również prace nad aktualizacją AI RMF 1.0, dlatego organizacje powinny śledzić zmiany standardu.
Najważniejsza zmiana polega na odejściu od założenia, że algorytmy są neutralne tylko dlatego, że wykorzystują matematykę. Ludzie decydują, jakie dane są zbierane, co model przewiduje, które zmienne uwzględnia i jakie błędy są akceptowalne. Określają również sposób wykorzystania wyników w praktyce. Automatyzacja nie usuwa ekonomicznego, instytucjonalnego ani społecznego kontekstu decyzji.
Jednocześnie algorytmy dają możliwość systematycznej oceny, która nie zawsze jest dostępna przy nieformalnych decyzjach podejmowanych przez ludzi. Wyniki i oceny modeli można mierzyć, porównywać oraz poddawać testom statystycznym. Pozwala to identyfikować nierówności i oceniać skuteczność działań naprawczych. AI może tworzyć, powielać lub ograniczać uprzedzenia, a dane pomagają ustalić, który proces rzeczywiście zachodzi.
Wiarygodna AI wymaga czegoś więcej niż wysokiej trafności prognoz. Potrzebne są dowody, że system działa odpowiednio dla wszystkich istotnych populacji, jasno określone kryteria sprawiedliwości i ciągłe monitorowanie. Konieczna jest także odpowiedzialność za błędne lub szkodliwe wyniki. Właściwe pytanie nie brzmi, czy AI zasługuje na bezwarunkowe zaufanie, lecz czy konkretny system dostarcza wystarczających dowodów uzasadniających to zaufanie.
Rozwijaj umiejętności ekonometryczne
Znajomość metod statystycznych i ekonometrycznych pomaga przekształcać złożone dane w użyteczne wnioski. Poznaj nasze publikacje ekonomiczne i praktyczne analizy lub rozwijaj umiejętności modelowania statystycznego. Sprawdź również korepetycje z ekonometrii i programowania, które wspierają rozwój praktycznych kompetencji analitycznych.